← 返回首页

学术

研究兴趣

从感知到推理,再到行动。探索视觉-语言-动作模型、具身智能、机器人操作、世界模型,以及面向真实世界决策的高效模型适配。

  • 视觉-语言-动作模型
  • 具身智能
  • 机器人操作
  • 世界模型
  • 高效多模态学习

精选论文

* 共同贡献。† 通讯作者。

已发表论文

ATI-VLA

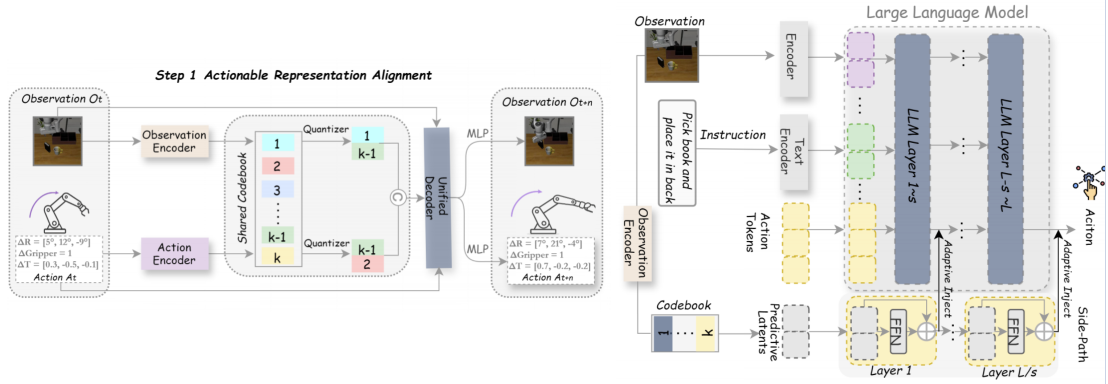
ATI-VLA: Action-Centric Predictive Vision–Language–Action Models via Actionable Alignment Then Adaptive Injection

Yijie Zhu, Rui Shao, Jie He, Wei Li, Bo Zhao, Yelin Wang, Xiaochen Yuan, Tao Tan, Miao Zhang, Xiaojiang Peng, Zitong YU

NeurIPS 2026.

ATI-VLA 以动作​​为中心,探索通过可行动对齐与自适应注入构建预测式视觉-语言-动作模型。

H-GAR

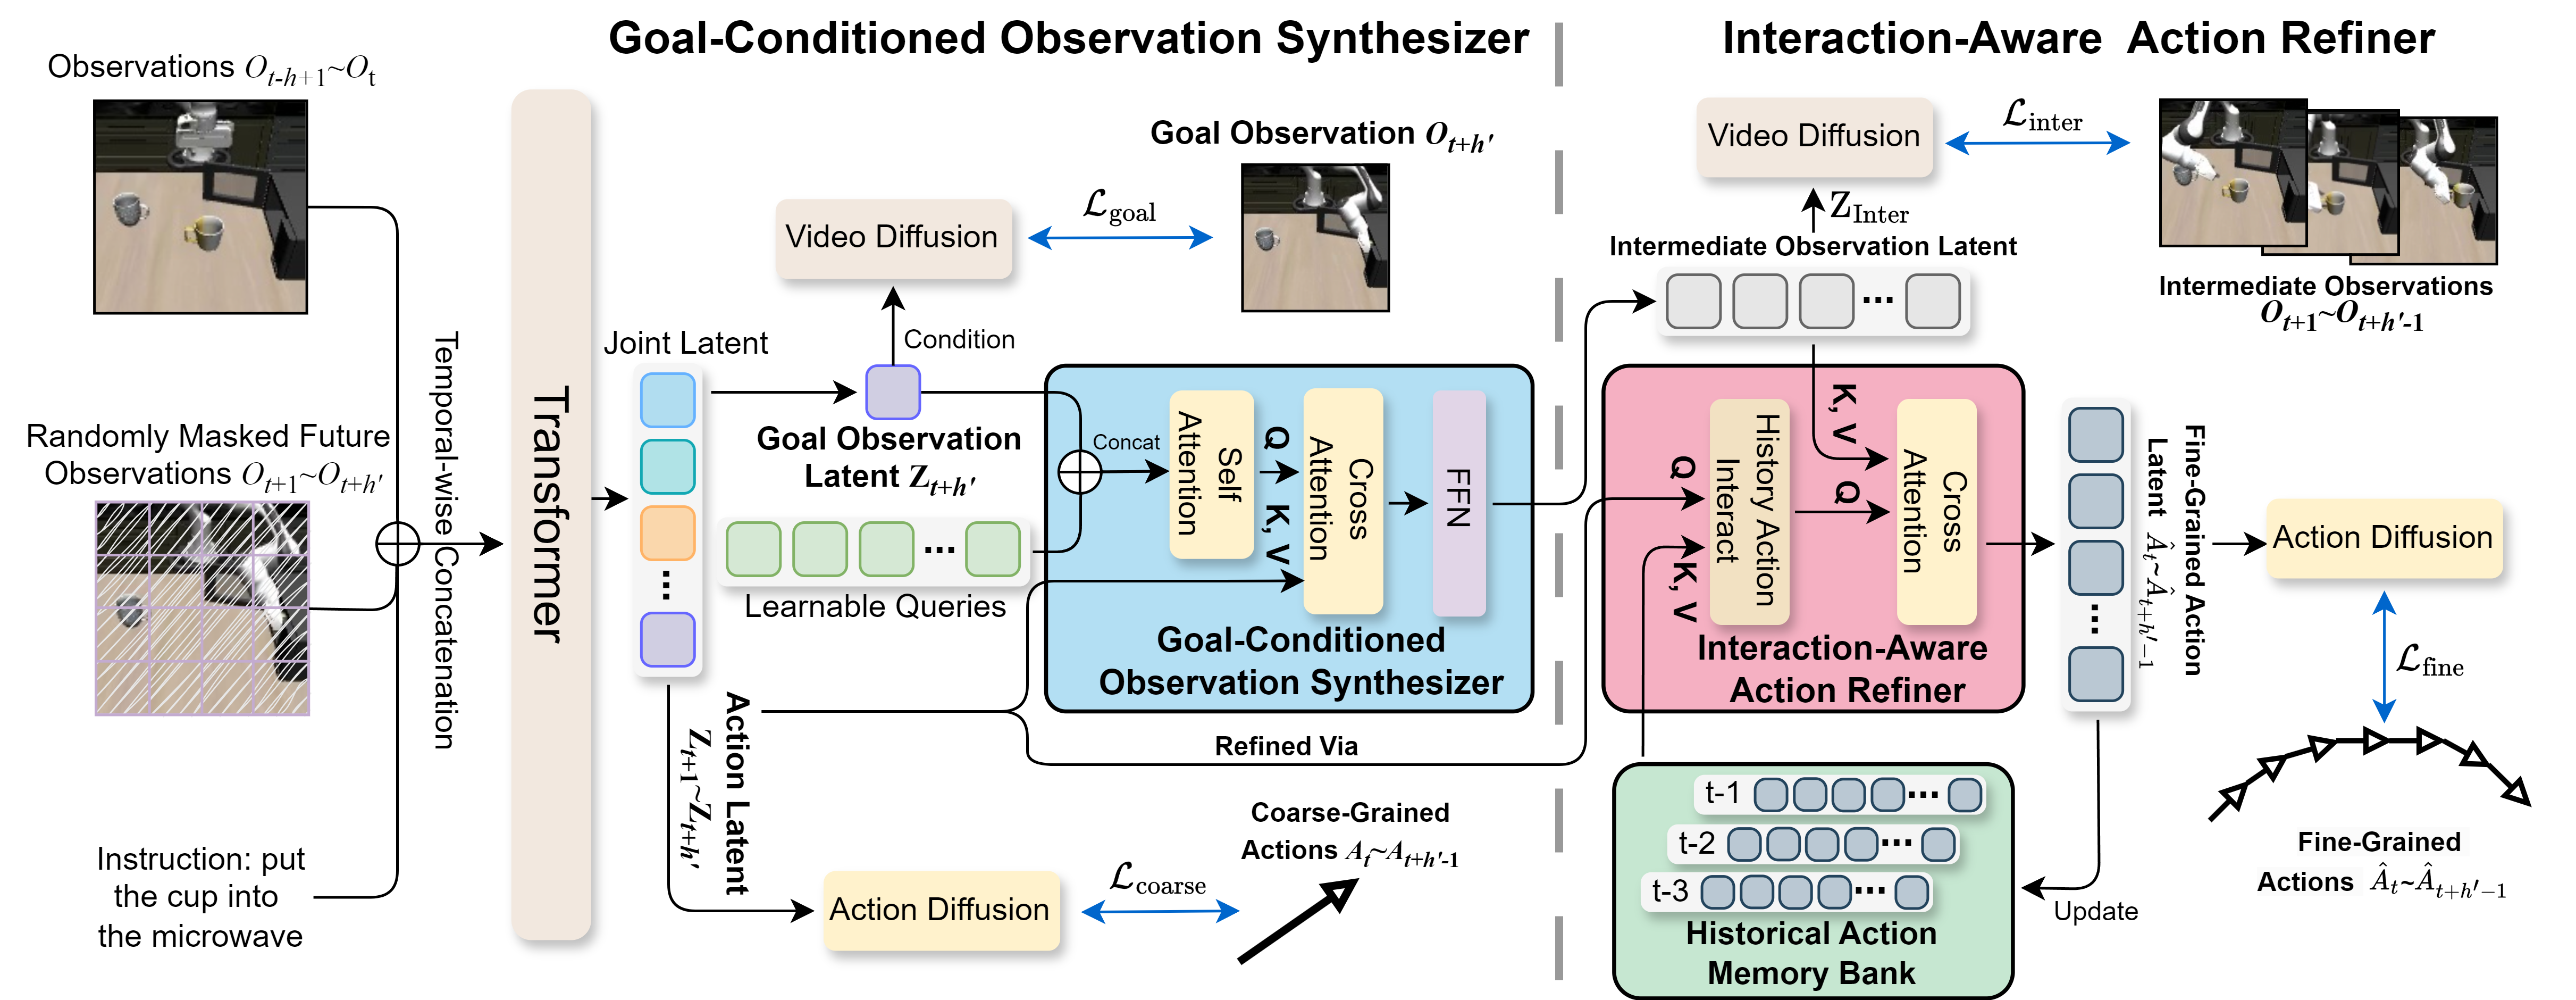
H-GAR: A Hierarchical Interaction Framework via Goal-Driven Observation-Action Refinement for Robotic Manipulation

Yijie Zhu, Rui Shao†, Ziyang Liu, Jie He, Jizhihui Liu, Jiuru Wang, Zitong Yu†

AAAI 2026 (口头报告).

H-GAR 提出用于机器人操作的层次化交互框架。它根据任务目标细化观察和动作,提升机器人对长时程交互的推理能力,并更精确地执行操作步骤。

CogVLA

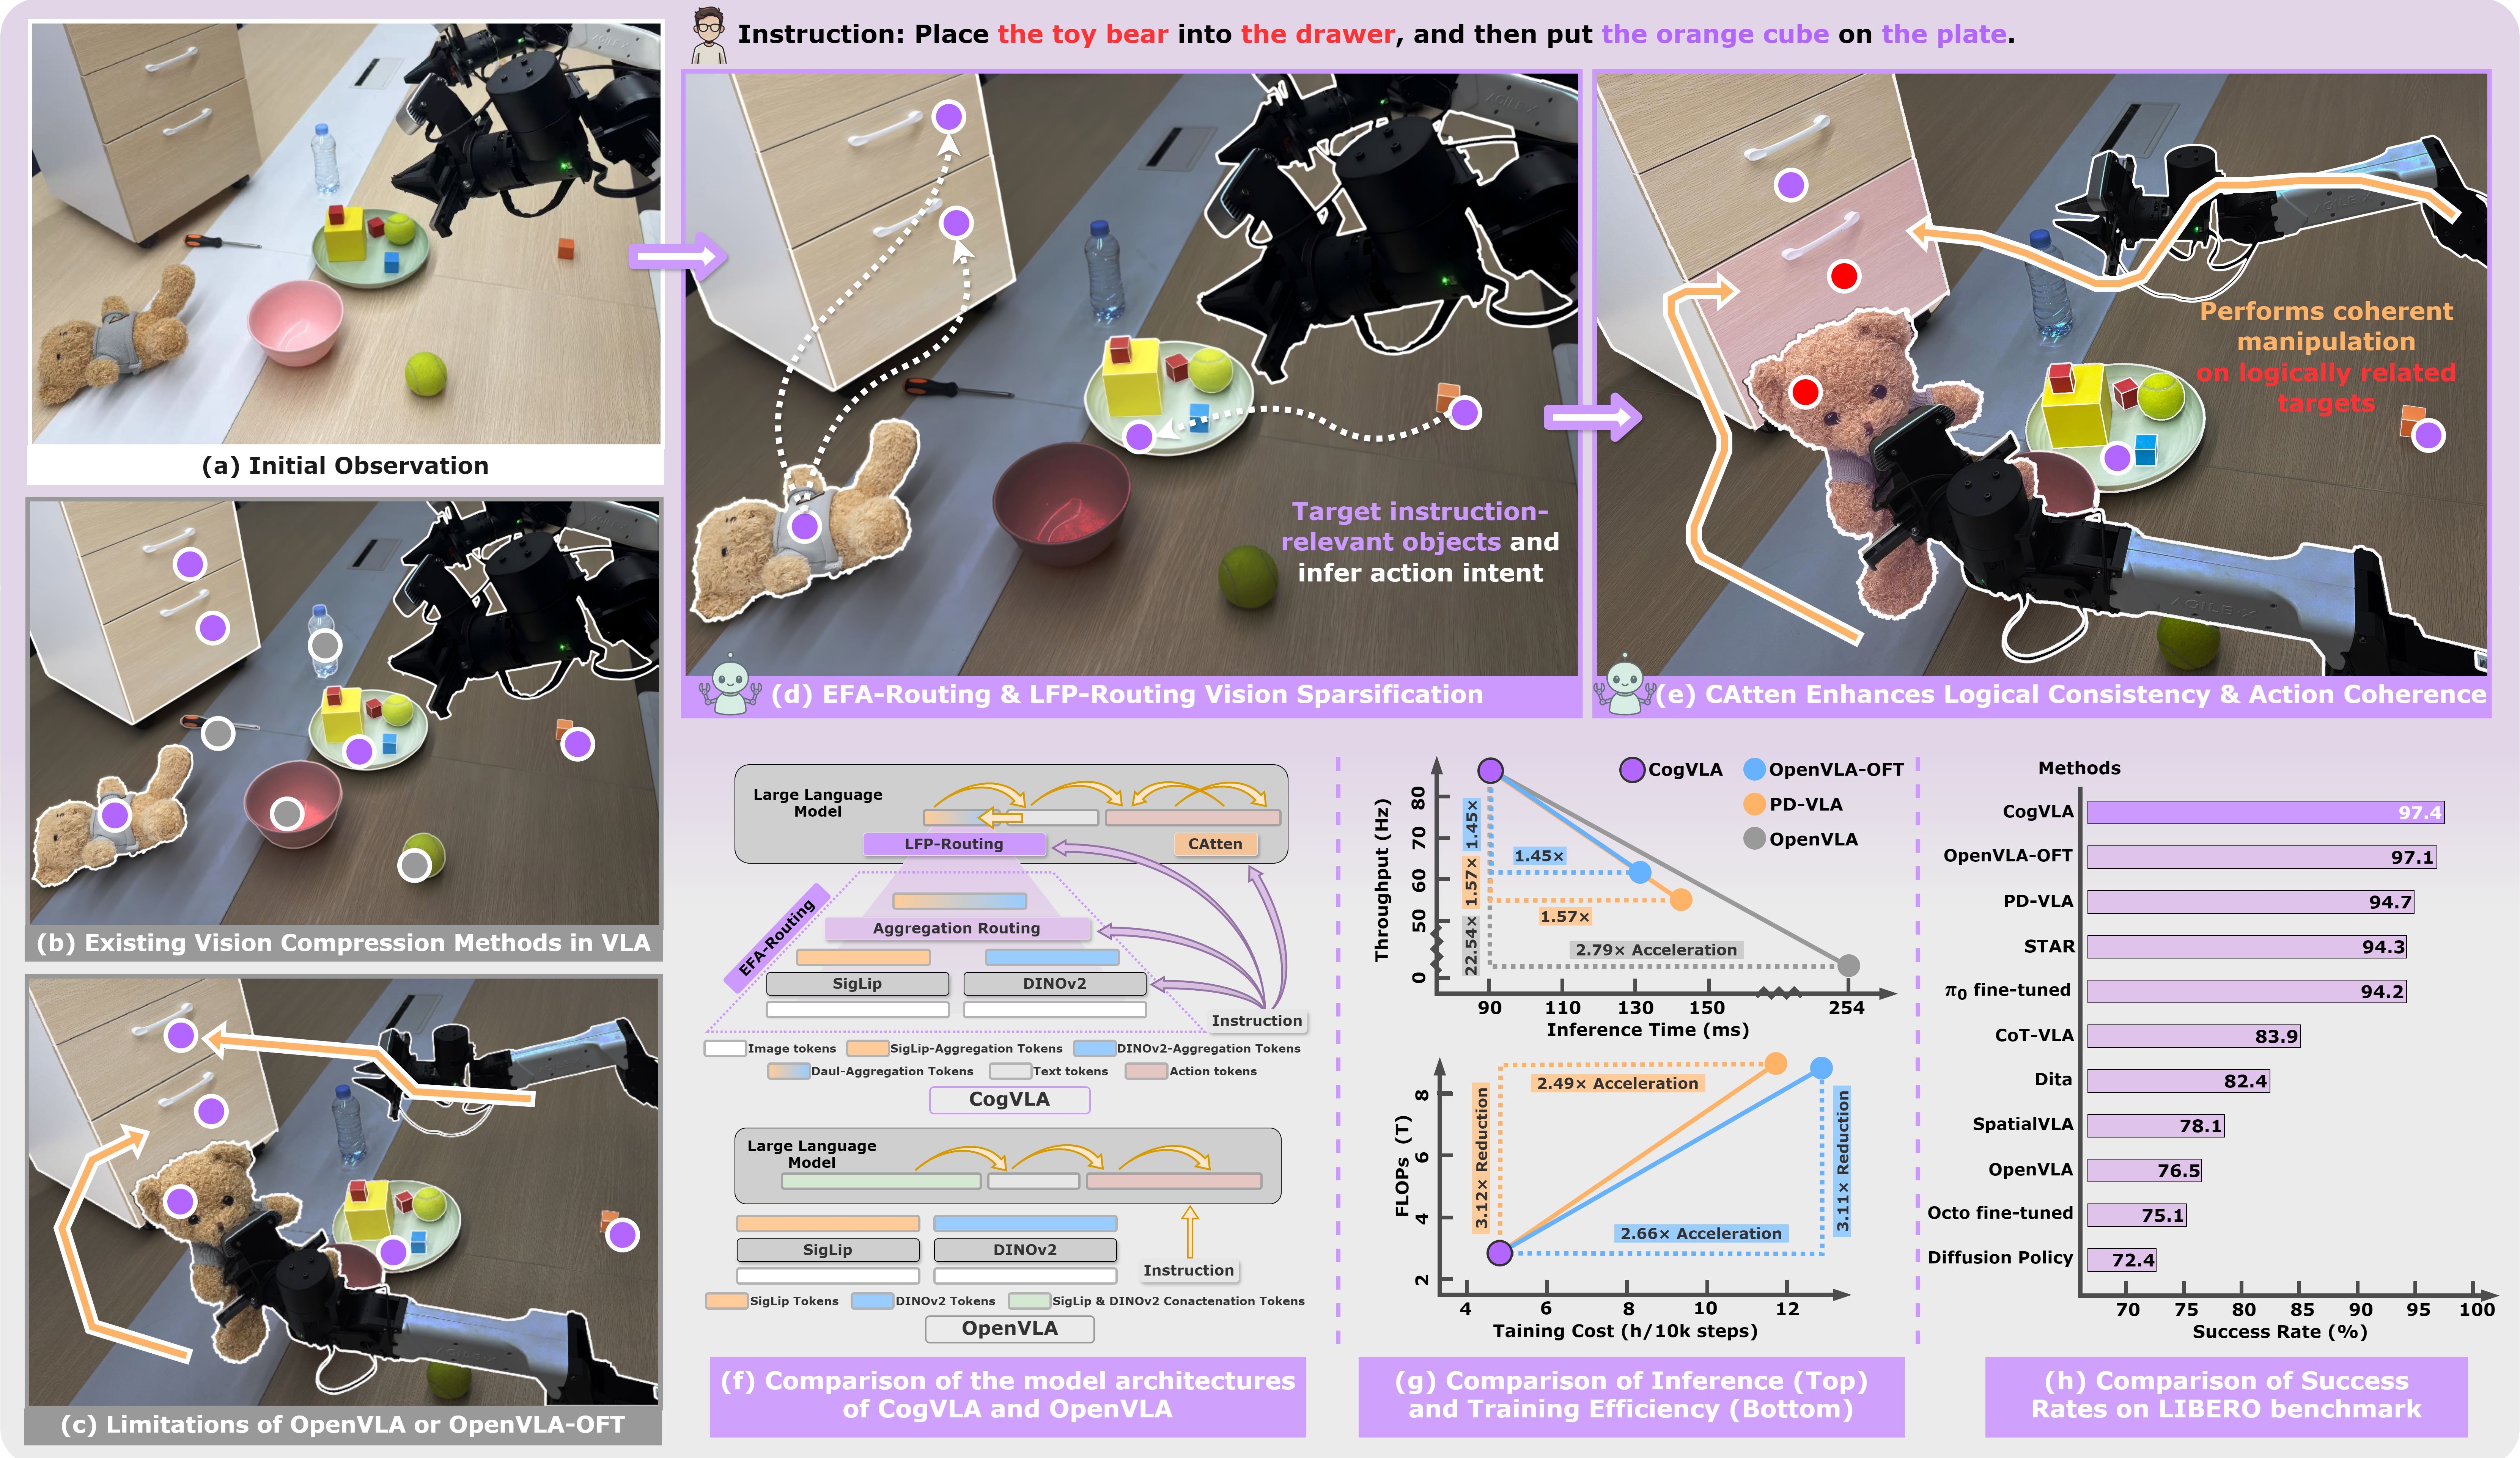
CogVLA: Cognition-Aligned Vision-Language-Action Models via Instruction-Driven Routing and Sparsification

Wei Li, Renshan Zhang, Rui Shao†, Jie He, Liqiang Nie

NeurIPS 2025.

CogVLA 通过指令驱动的路由与稀疏化,使视觉-语言-动作模型与认知执行模式对齐。它旨在实现高效、任务感知的推理,让模型激活与具身决策最相关的路径。

预印本与在审论文

VLDA

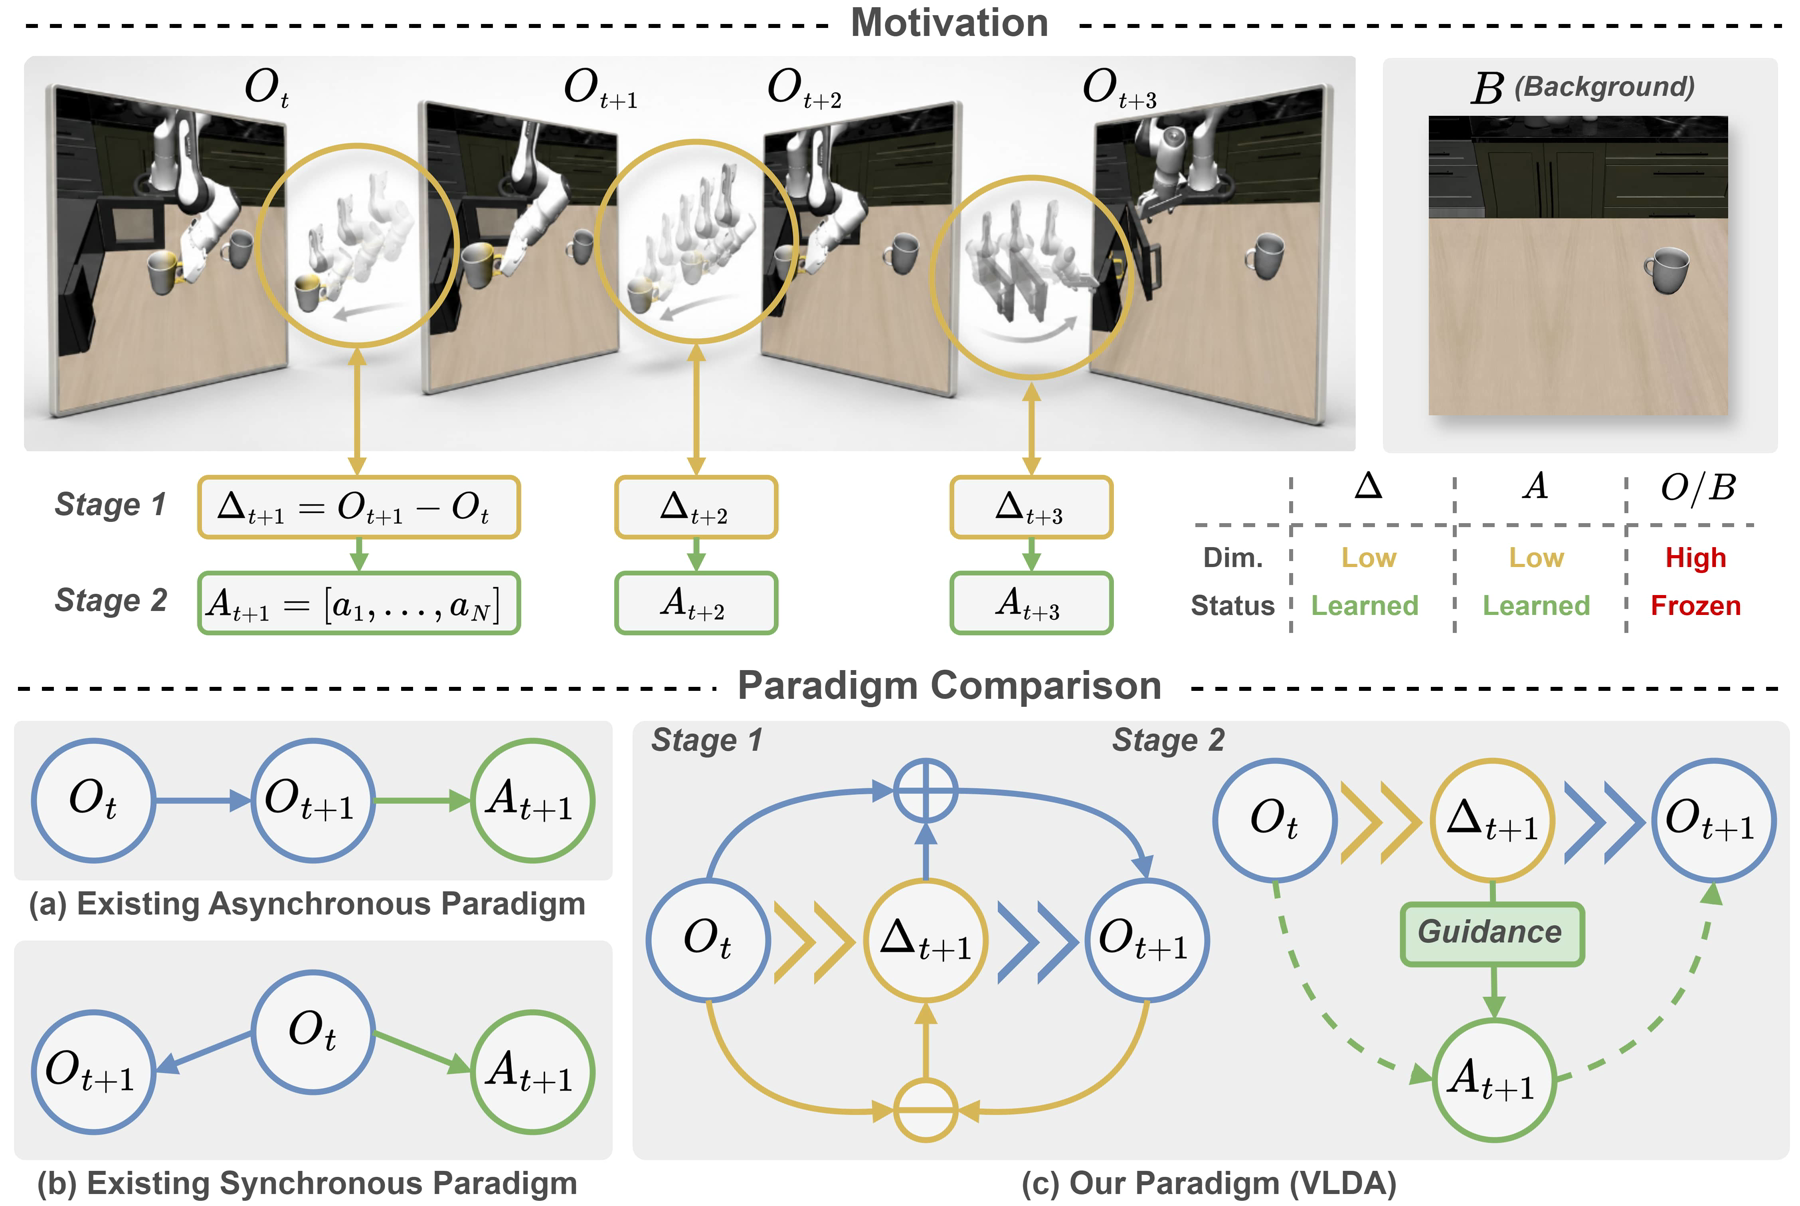
Vision-Language-Delta-Action: Learning Compact Deltas as Actionable Transition Interfaces for Robotic Manipulation

Lingsen Zhang, Wei Li, Jie He, Henghua Zhang, Kai Mo, Shiyong Li, Yanpeng Wang, Rui Shao

arXiv 预印本 arXiv:2610.25874,2026。

VLDA 以紧凑的 Delta 变量建模与任务相关的世界状态变化,连接视觉语言理解与动作生成,并通过 Delta 引导的动作细化提升机器人操作的长时程一致性、鲁棒性与泛化能力。

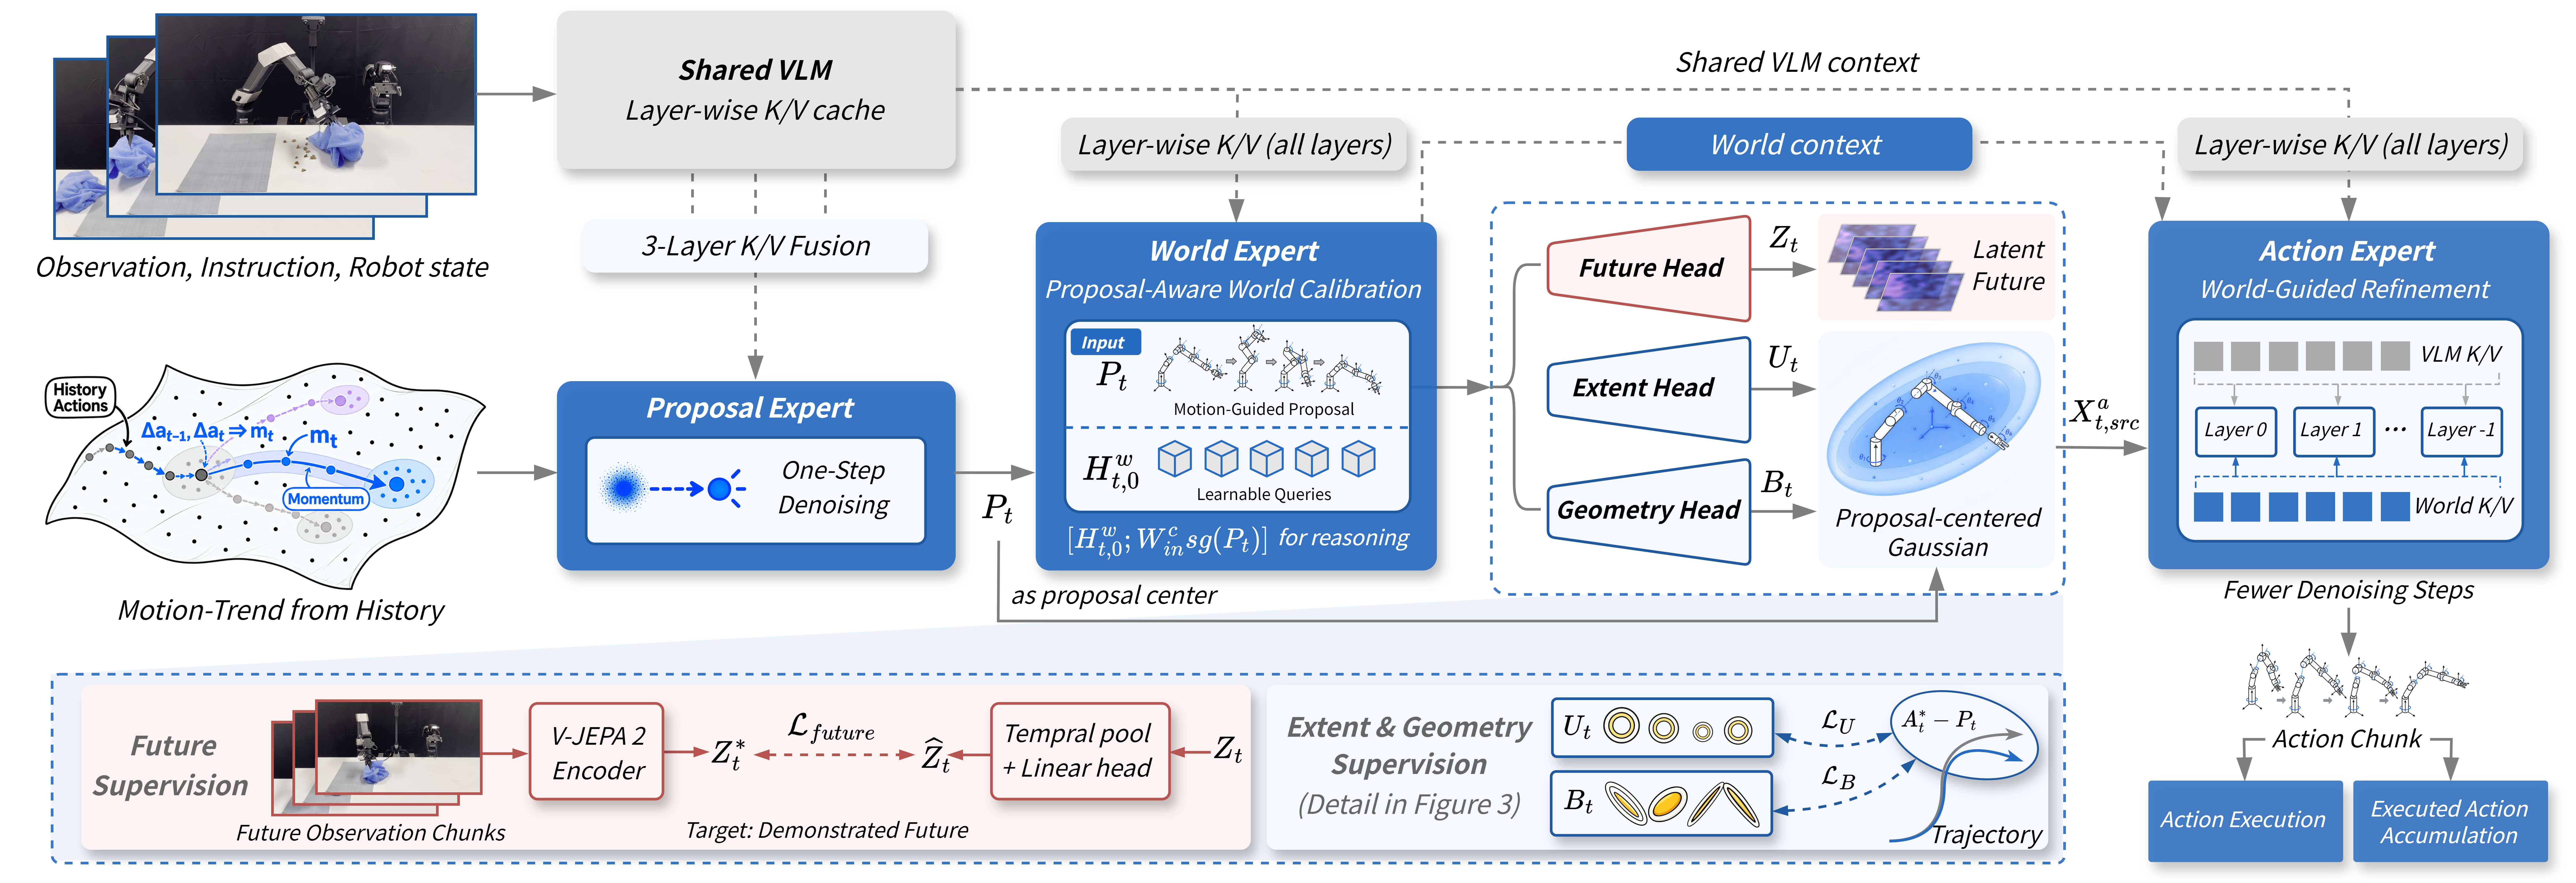
World-Calibrated Proposal-to-Action Flow

World-Calibrated Proposal-to-Action Flow for Vision-Language-Action Models

Jie He, Wei Li, Junwen Tong, Rui Shao, Wei-Shi Zheng, Liqiang Nie

arXiv 预印本 arXiv:2610.02323,2026。

该工作探索面向视觉-语言-动作模型的世界校准 proposal-to-action 流程,以更好地连接世界建模、动作提议与动作执行。

UniMPA

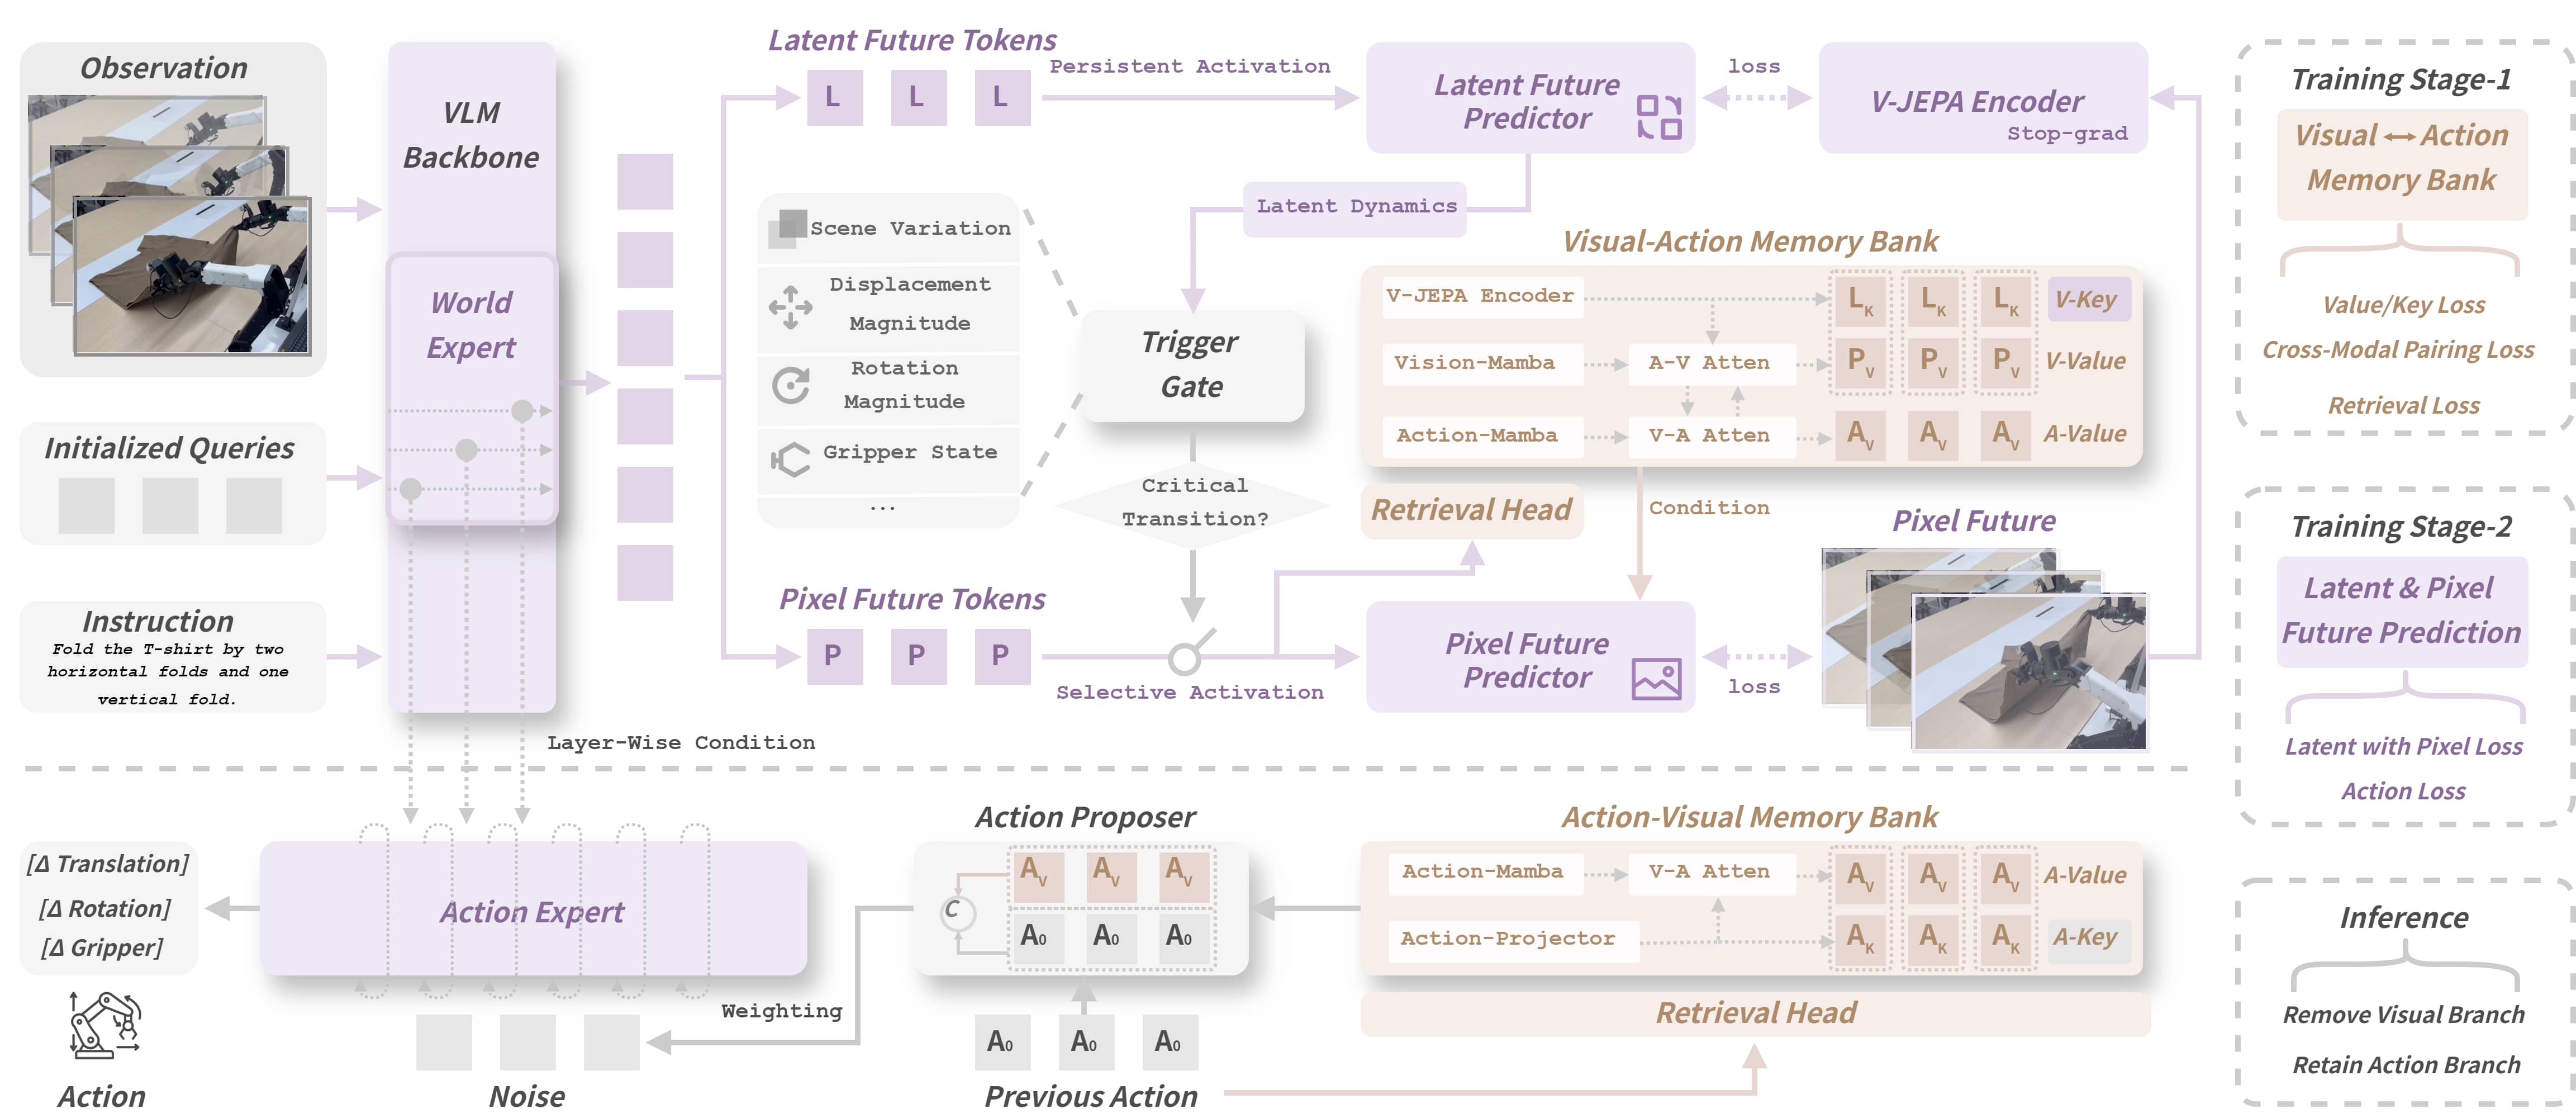
UniMPA: A Unified Memory-Prediction-Action Model via Action-Grounded Transition Modeling

Wei Li, Rui Shao, Jie He, Lingsen Zhang, Ziwei Liu, Liqiang Nie

arXiv 预印本 arXiv:2609.11875,2026。

UniMPA 提出统一的记忆-预测-动作模型,通过动作​​ grounded 的转移建模连接视觉记忆、未来预测与动作决策。

ΔVLA

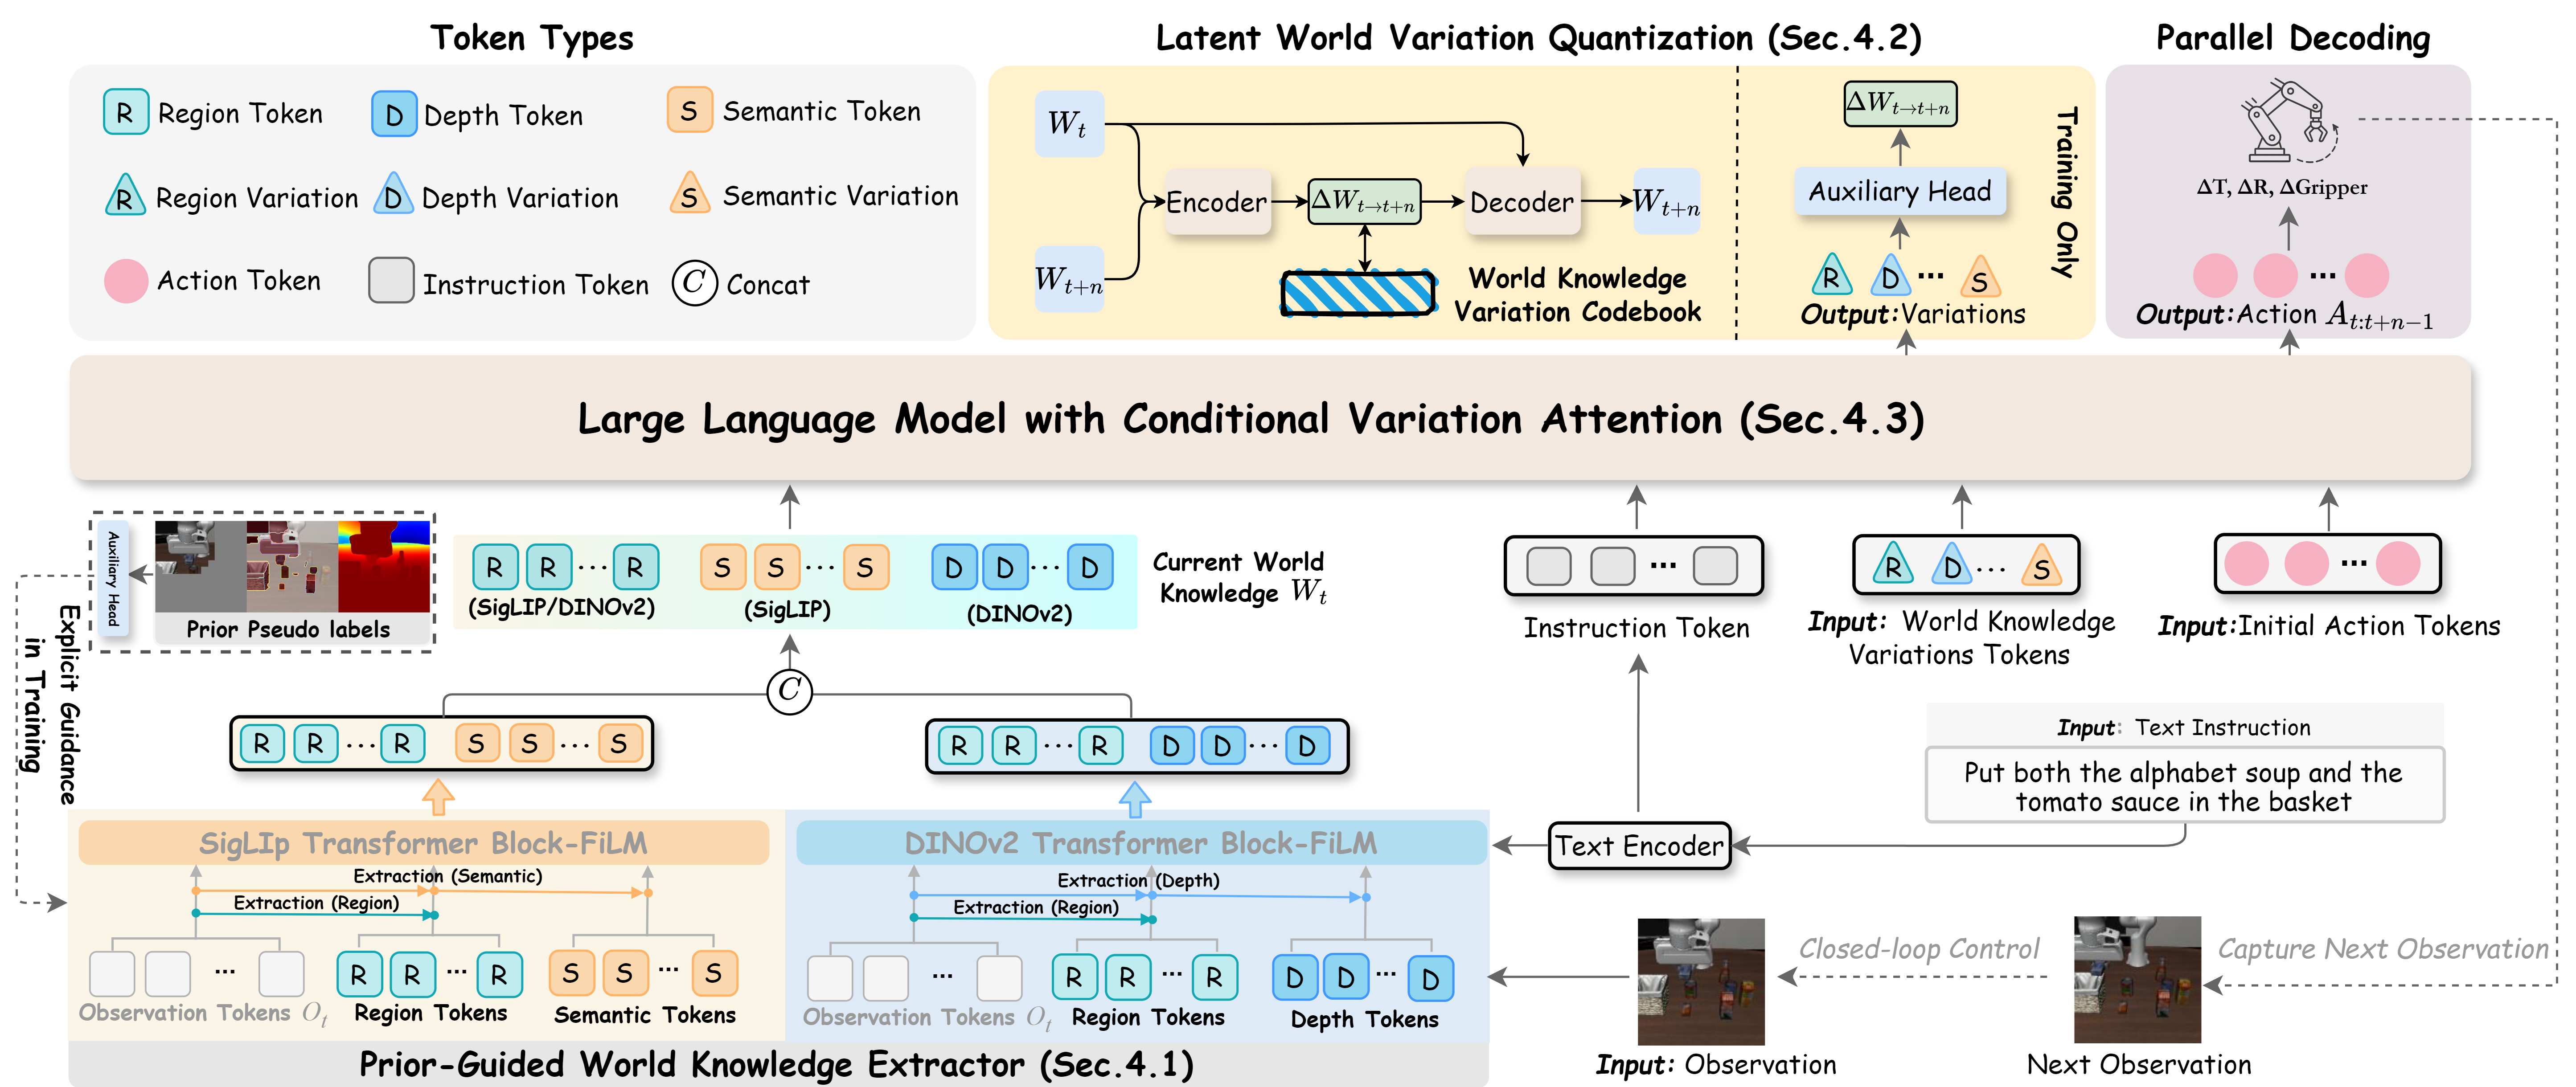
ΔVLA: Prior-Guided Vision-Language-Action Models via World Knowledge Variation

Yijie Zhu, Jie He, Rui Shao†, Kaishen Yuan, Tao Tan, Xiaochen Yuan, Zitong Yu†

arXiv 预印本 arXiv:2603.08361,2026。

ΔVLA 研究如何利用世界知识变化引导视觉-语言-动作模型。该工作通过先验知识改善动作推理与适配,旨在提高具身策略在任务和场景条件变化时的可靠性。